
Mit strukturierten Daten, llms.txt und maschinenlesbaren Feeds kannst Du Suchmaschinen und KI-Systemen zentrale Informationen liefern. Der Text zeigt, welche Datenarten in Shopware praktisch Mehrwert bringen und welche Voraussetzungen Du beachten musst.
Dieser Beitrag erklärt praxisnah, welche JSON-LD Rich Snippets in Shopware echte Sichtbarkeit liefern, wie sich Produkt-, Kategorie-, Organisations- und FAQ-Daten zentral ausspielen lassen und welchen Beitrag llms.txt sowie KI-Feeds leisten. Du bekommst konkrete Einsatzfälle, Beschränkungen der Lösung sowie Hinweise zur Kompatibilität (Shopware 6.5–6.7) und zum erwartbaren Nutzen.
Woran erkennst Du, dass fehlende strukturierte Daten ein konkretes Shopproblem sind?
Wenn Deine Suchergebnisse keine Preis-, Verfügbarkeits- oder Bewertungsinfos anzeigen und Kategorieseiten wenig Kontext in den SERPs haben, sind strukturierte Daten eine mögliche Ursache.
Konkretere Diagnostik: Beginne mit visuellen Prüfungen in den Suchergebnissen und mit KI‑Antworten, dann arbeite systematisch. Öffne einige Produkt‑ und Kategorieseiten und suche im Seitenquelltext explizit nach <script type=“application/ld+json“>. Fehlt ein JSON‑LD‑Block komplett, ist das ein klarer Befund. Falls ein Block vorhanden ist, prüfe, ob die wichtigsten Felder (Offer mit price und priceCurrency, availability, aggregateRating oder Review‑Informationen) tatsächlich gefüllt sind oder nur leere/platzhalterartige Felder enthalten.
Weitere sinnvolle Prüfungen:
- Rich‑Results‑ und Schema‑Validatoren: Nutze die offiziellen Tools zur Fehlermeldung und zur Erkennung fehlender Property‑Zuweisungen.
- Search Console: Schau in die Enhancements/Structured Data Reports – fehlende oder fehlerhafte Items werden dort oft gelistet.
- Server‑Logs und Bot‑Zugriffe: Prüfe, ob Crawler die JSON‑LD‑Ressourcen fehlerfrei abrufen. Manche Bots sehen eine vereinfachte, gecachte oder anders ausgegebene Version.
- KI‑Testqueries: Stelle produktbezogene Fragen an die KI oder an interne Retrieval‑Systeme. Wenn die Antworten Preise, Verfügbarkeit oder Varianteninformationen nicht korrekt wiedergeben, fehlt oft maschinenlesbarer Input oder er steht nicht in standardisierter Form zur Verfügung.
Typische Fehlerbilder, die auf ein strukturiertes‑Daten‑Problem hinweisen: sichtbare Inhalte widersprechen dem JSON‑LD (etwa Preis im Frontend ändert sich, JSON‑LD bleibt alt), doppelte oder widersprüchliche JSON‑LD‑Blöcke auf einer Seite, fehlende Variantenkennungen (GTIN/MPN) auf Variantenseiten und JSON‑LD, das ausschließlich clientseitig per JavaScript injiziert wird, sodass manche Indexer es nicht zuverlässig sehen.
Entscheidungskriterien: Wenn das Problem einzelne, unwichtige Seiten betrifft, reicht punktuelle Korrektur. Wenn es aber systematisch auftritt – z. B. bei vielen Produktseiten, bei allen Kategorie‑Seiten oder bei typischen Nutzeranfragen an KI, ist eine zentrale, skalierbare Lösung sinnvoller als viele einzelne Quickfixes.
Wie unterscheidet sich der Aufwand: Manuelle Markup-Pflege versus zentrale JSON-LD-Ausspielung?
Manuelle Pflege von strukturierten Daten pro Template oder Artikel skaliert schlecht und erzeugt Inkonsistenzen.
Konkrete Unterschiede in Aufwand und Risiko:
- Skalierung und Drift: Bei manueller Pflege musst Du für jedes Template, Theme‑Update oder neue Produktseite die Markup‑Felder anpassen. Das bedeutet mehr Tests bei Releases und erhöht die Wahrscheinlichkeit für Inkonsistenzen, wenn z. B. Entwickler unterschiedliche Namenskonventionen für Felder verwenden.
- Single Source of Truth: Eine zentrale JSON‑LD‑Generierung aus dem Produktstamm (PIM/Shop‑DB) schafft eine einzige Mapping‑Logik. Das reduziert Duplikation, weil Produktdaten, Preise, Versandprofile und Rückgaberegeln einmal zusammengeführt werden und von dort sowohl an das Frontend als auch an Feeds/llms.txt ausgegeben werden können.
- Deployment und Tests: Zentral erzeugte Schemas kannst Du leichter unit‑testen, als Labels und JSON‑Fragmente über viele Templates zu verteilen. Implementiere automatische Snapshot‑Tests für Schema‑Generierung und validiere gegen Schema‑Validatoren in der CI‑Pipeline.
- Performance und Invalidation: Zentral bedeutet auch, dass Du Caching‑Strategien planst. Preise und Verfügbarkeiten ändern sich häufig, hier brauchst Du ein sinnvolles Invalidation‑Verfahren (z. B. Cache‑Keys an Preis/Stock‑Version koppeln oder Event‑basierte Invalidierung). Ohne zentrale Steuerung ist das fehleranfälliger.
Implementationsmuster:
- Serverseitige Generierung: JSON‑LD wird beim Rendern injiziert (zuverlässig für Suchmaschinen und externe Crawler).
- Edge/Service‑Layer: Ein dedizierter Microservice oder Endpoint liefert die strukturierte Darstellung als API, die Frontend oder Feeds konsumieren.
- Template‑Helper: Ein zentraler Renderer als Library, die in Templates aufgerufen wird, um gleiches Output‑Format zu garantieren.
Typische Fallen bei Zentralisierung: unvollständige Feldzuordnungen zwischen PIM und Shop‑DB, Blindvertrauen auf zentrale Logs ohne echte End‑to‑End‑Checks, und zu groß geratene JSON‑LD‑Blöcke, die unnötig viele interne Metadaten enthalten. Wichtig ist, dass zentrale Ausspielung zwar die Qualität und Konsistenz erhöht, aber keine Garantie für Rich Results oder KI‑Präsentation bietet, die Indexer entscheiden letztlich.
Wie funktioniert zentrale Ausspielung von Produkt-, Kategorie-, FAQ- und Organisationsdaten praktisch?
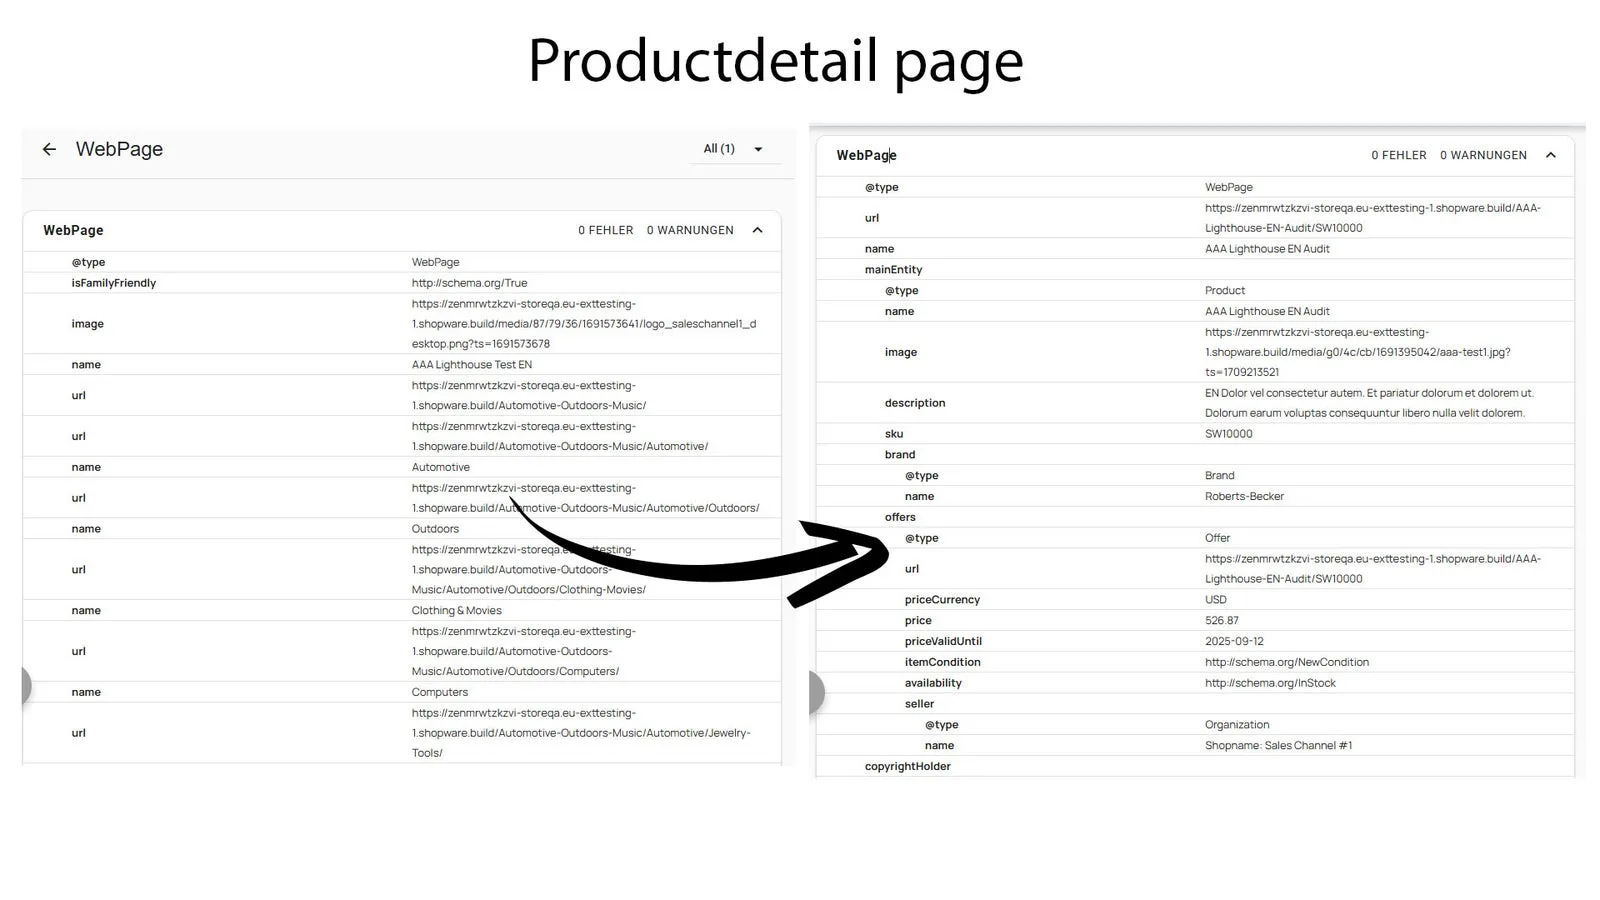
Das Plugin erzeugt Google‑konforme JSON‑LD‑Snippets für Produkte, Kategorien, Organisation und FAQ und stellt diese zentral bereit.
Praktische Architektur und Mapping‑Details:
- Datenquelle: Ziehe Stammdaten aus PIM bzw. dem Shop‑Backoffice (Produktidentifikatoren, Preise, Versandprofile, Rückgaberegeln, Bewertungen). Pflege‑felder sollten klar definiert sein; z. B. was wirklich eine GTIN ist und auf welcher Ebene (Parent‑SKU vs. Variant) sie steht.
- Schemaaufbau: Erzeuge klar getrennte Blöcke für Product, Offer, AggregateRating/Review, BreadcrumbList, ItemList, Organization und FAQPage. Verwende @id für Entitäten, damit unterschiedliche Schemata auf verschiedene Seiten eindeutig verknüpft werden können.
- Mapping von OfferShippingDetails/MerchantReturnPolicy: Diese Informationen sollten aus den Versandprofilen und Rückgabe‑Einstellungen kommen. Konstruiere sinnvolle, deklarative Felder statt freier Texte, damit Maschinen die Angaben verarbeiten können.
- Kategoriestruktur: Verwende ItemList auf Kategorieseiten mit ListItem‑Einträgen, die auf die Produkt‑@id verweisen. Achte bei Paginierung darauf, keine widersprüchlichen itemListElement‑Positionen auszugeben und setze canonical/rel‑next‑rel‑prev richtig, damit die Liste als logisch zusammenhängend lesbar bleibt.
- Varianten und Identifikation: Gib GTIN/MPN nur dort aus, wo sie eindeutig zu einer Variante gehören. Für Parent‑Produkte nutze eine klare Kennzeichnung, ansonsten liefern Variantenseiten die genaue Identifikation.
- FAQ‑Integration: FAQ‑Inhalte sollten exakt die Q/A‑Texte widerspiegeln, die Nutzer auch sehen. Synchronisiere das Frontend‑Akkordeon mit dem FAQPage‑Schema, damit keine Diskrepanz entsteht.
Technische Hinweise und Fehlerquellen:
- Clientseitig erzeugtes JSON‑LD kann von einigen Indexern schlechter erkannt werden, bevorzugt serverseitige Einbettung.
- Vermeide widersprüchliche Angaben: Wenn im Frontend ein Preis sichtbar ist, muss das Offer‑Objekt denselben Preis zeigen. Andernfalls erzeugst Du Vertrauenseinbußen und mögliche Abstrafungen durch Suchmaschinen.
- Content‑Policy/CSP: Manche Shops haben restriktive Content Security Policies, die inline‑Scripts blockieren. Dann muss JSON‑LD extern oder via verträglicher CSP‑Konfiguration bereitgestellt werden.
- Sichtbarkeit vs. Verstecken: Vermeide, Daten nur im JSON‑LD auszugeben, die für den Nutzer nicht sichtbar sind, das kann als irreführend angesehen werden.
Wartung: Ändert sich ein Versandprofil, eine Rückgabeoption oder Domain/URL‑Struktur, sollte die zentrale Generierung diese Änderungen automatisch reflektieren; setze Tests und Monitoring auf, um Drift zu entdecken.
Wann sind llms.txt und maschinenlesbare Feeds für KI-Suchsysteme sinnvoll?
llms.txt und maschinenlesbare Feeds sind sinnvoll, wenn Du explizit willst, dass KI-Suchsysteme strukturierte Produkt- und Kategoriesignale konsumieren können.
Wofür dienen sie und wie unterscheiden sie sich von JSON‑LD im HTML?
- llms.txt dient als deklarative „Hinweisdatei“ für LLM‑indexer: Sie signalisiert, wo relevante Feeds oder Regeln für das automatische Crawling und die Nutzung stehen. Analog zur robots.txt ist sie ein Einstiegspunkt, der Indexern Orientierung gibt, aber sie erzwingt keine Nutzung.
- Maschinenlesbare Feeds (JSON, CSV, XML) bieten einen leicht konsumierbaren Endpunkt für große, regelmäßige Abrufe, deutlich effizienter für großflächige Indexierungen als Einzelseiten‑Scraping.
Wann Du Feeds/llms.txt in Betracht ziehen solltest:
- Wenn externe KI‑Anbieter, Vergleichsportale oder interne Retrieval‑Pipelines großen Zugriff auf strukturierten Katalog benötigen.
- Wenn Dein Katalog sehr groß ist oder sich häufig ändert und Du ein performantes, differenziertes Abrufverfahren brauchst (z. B. Full vs. Delta‑Feeds).
- Wenn Du explizit kontrollieren willst, welche Daten offen zugänglich sind, und in welcher Granularität (z. B. nur Produkt‑Metadaten ohne PII oder Bestellinformationen).
Operationale Aspekte:
- Formatwahl: JSON ist für KI‑Verbraucher meist am praktischsten, weil es verschachtelte Strukturen gut abbildet. CSV kann für einfache Attribute genügen, XML wird seltener für AI‑Pipelines genutzt, aber ist kompatibel mit manchen Legacy‑Systemen.
- Delta vs. Full: Biete beide Modi an, wenn Echtzeit‑ oder häufige Aktualisierungen nötig sind. Implementiere klare Änderungsmetadaten (lastUpdated, changeType) und ein verlässliches Schema‑Versioning.
- Sicherheit und Governance: Kontrolliere, welche Daten Du offenlegst. Nutze authenticated feeds oder signierte URLs für sensible Informationen. Dokumentiere Nutzungsbedingungen und Lizenz, damit Dritte wissen, wie Daten genutzt werden dürfen.
- Monitoring: Beobachte Zugriffsmuster auf Feeds, setze Rate‑Limiting und analysiere, ob externe Systeme die angebotenen Daten tatsächlich verarbeiten. Logging hilft, fehlerhafte Feed‑Versionen und Kontaktpunkte mit externen Indexern nachzuverfolgen.
Wichtig: Das Bereitstellen von llms.txt/Feeds erhöht die Chancen, dass KI‑Systeme Deine Daten sehen, erzwingt aber nicht deren Nutzung oder Priorisierung. Außerdem gelten dieselben rechtlichen Anforderungen wie bei allgemeinen Datenzugriffen, achte auf Datenschutz und Vertragsbedingungen bei Drittparteien.
Welche Voraussetzungen, Einschränkungen und Einsatzszenarien sind bei der zentralen Lösung zu beachten?
Die Erweiterung ist mit Shopware-Versionen 6.5.0.0 bis 6.7.13.0 kompatibel. Während eines aktiven Abonnements sind Updates und Support durch den Extension Partner inklusive, und es gibt einen kostenlosen Probemonat.
Voraussetzungen für eine erfolgreiche Integration:
- Zugriff auf Stammdaten: Du brauchst saubere Produktstämme (PIM/Shop‑DB) mit korrekten IDs, Preisen, Verfügbarkeiten, Versand‑ und Rückgabeinformationen sowie Reviews/Rating‑Daten.
- Serverseitiges Rendering oder eine zuverlässige Mechanik zur Bereitstellung von JSON‑LD: Clientseitige Injection ist bequem, aber nicht so robust für alle Crawler.
- Möglichkeit, Schemata und CSP anzupassen, damit JSON‑LD‑Blöcke nicht blockiert werden.
Einschränkungen und Grenzen:
- Plattformbindung: Die Plugin‑Kompatibilität ist auf Shopware‑Versionen beschränkt, für andere Plattformen ist entweder eine Portierung nötig oder eine alternative Lösung.
- Kein Garant für Rich Results: Strukturierte Daten erhöhen die Chancen auf erweiterte Darstellungen, garantieren sie aber nicht. Suchmaschinen und KI‑Produkte treffen letztlich die Entscheidung, was angezeigt wird.
- Anforderungen an Sonderformate: Wenn Drittanbieter ein proprietäres Datenformat verlangen, kann das Plugin nicht unbedingt jede individuelle Datenstruktur abbilden.
Einsatzszenarien, in denen die Lösung besonders sinnvoll ist:
- Du betreibst einen umfangreichen Katalog und willst konsistente, maschinenlesbare Produkt‑ und Kategoriesignale aus einer Hand anbieten.
- Du planst, externe KI‑Indexierer oder Vergleichsportale zu unterstützen und willst kontrollierte, dokumentierte Feeds und llms.txt‑Signale bereitstellen.
- Du willst Schemata zentral pflegen und durch CI‑Tests absichern, statt Markup in vielen Templates zu verteilen.
Wann die Lösung nicht passt:
- Wenn Dein System stark individualisierte, proprietäre Datenexporte braucht, die außerhalb der standardisierten Schemata liegen.
- Wenn Deine Infrastruktur keine serverseitige Einbettung von JSON‑LD erlaubt oder Du nicht die nötigen Werkzeuge zur Invalidation/Cache‑Kontrolle bereitstellen kannst.
Operationaler Rat: Strukturierte Daten sind ein technisches Hilfsmittel, ersetzen aber keine inhaltliche Arbeit. Pflege von Produkttexten, Bildqualität, Nutzerbewertungen und Preisgestaltung bleibt erforderlich. Plane die Einführung als Teil eines Gesamtprozesses: technische Bereitstellung, Automatisierung (CI/Test), Monitoring und laufende inhaltliche Optimierung.
Häufige Fragen
Unterstützt das Plugin GTIN, MPN und Produktmaße?
Ja. Das Plugin unterstützt das Produkt-Schema inklusive GTIN/MPN sowie Angaben zu Maßen und Eigenschaften. Diese Angaben werden im JSON-LD-Ausgabeformat bereitgestellt.
Wird die Erweiterung automatisch hreflang- und canonical-Tags verwalten?
Die Erweiterung bietet Canonical- & Pagination-Handling sowie automatisches hreflang laut Funktionsbeschreibung. Für spezielle Multidomain-Setups prüfe die Kompatibilität mit Deiner Implementierung.
Gibt es eine Garantie, dass Google Rich Results anzeigt?
Nein. Das Plugin liefert Google-konforme JSON-LD-Snippets, aber die Entscheidung über die Anzeige von Rich Results trifft die Suchmaschine. Strukturierte Daten erhöhen die Chance, sind aber keine Garantie.
Kann das Plugin noindex für Account- oder Checkout-Bereiche setzen?
Ja. Die Erweiterung bietet noindex/nofollow-Steuerung für Account, Checkout und Wishlist sowie für einzelne Kategorien und statische Seiten.
Fazit
Die zentrale Ausspielung von JSON-LD für Produkt-, Kategorie-, Organisations- und FAQ-Daten sowie die Bereitstellung von llms.txt und maschinenlesbaren Feeds reduziert Pflegeaufwand und liefert standardisierte Signale an Suchmaschinen und KI-Systeme. Prüfe die Shopware-Kompatibilität (6.5.0.0–6.7.13.0) und die Projektanforderungen, bevor Du die Lösung einsetzt.
Handlungsempfehlung: Plugin im Shopware Store ansehen: Rich Snippets JSON-LD & SEO/AI-Sichtbarkeit.

